

 Индустрии
 Специализации
 Типы задач
 Типы ботов

Существует два подхода в обучении роботов – обучение на примерах состоявшихся диалогов и создание базы знаний. Некоторые компании-разработчики предлагают обучать ботов на примерах успешных диалогов – просто загрузить диалоги в ML-модель и обучить ее отвечать на основе вопросов и ответов из этих диалогов. Такой способ кажется более простым и быстрым по сравнению с кропотливым созданием базы знаний. Но позволяет ли он достичь высокой точности ответов?
На эту тему поговорили с Сергеем Четвертаковым, генеральным директором Проф ИТ и архитектором решения Vocamate AI.
Как добиться высокой точности ответов и какой подход применять – обучение ботов на примерах успешных диалогов или создание наиболее полной базы знаний, к которой будут обращаться роботы?
Сергей Четвертаков:
Обучение роботов на истории диалогов принесет результат только в идеальном мире – если операторы отвечают на вопросы заранее заготовленными шаблонами. Но в реальности на один и тот же вопрос операторы, как правило, формулируют ответ по-разному в зависимости от времени, контекста и т.д. Например, один и тот же вопрос был задан 10 раз и на него есть разных 10 вариантов ответов. Какой из них будет правильным использовать в качестве эталонного, на который должны ориентироваться роботы? Мы можем отдать все варианты ответов в LLM, но нет гарантии, что она выберет наиболее релевантный вариант. Таким образом, обучение ботов будет проводиться не на основе первоисточника – стандартизированной информации, а на основе ее интерпретации операторами, что негативно повлияет на качество ответов ботов.
То же касается и запроса пользователя?
Сергей Четвертаков:
Конечно. Один и тот же вопрос может быть сформулирован по-разному. Бот, обученный на таких данных, не сможет дать корректный ответ на слегка по-другому сформулированный вопрос. В результате добиться того, чтобы бот, обучившийся на основе истории диалогов, отвечал корректно хотя бы в 40% случаев, довольно сложно. Для того, чтобы этот метод работал, нужно, чтобы операторы отвечали шаблонами, а пользователи задавали свои вопросы и отвечали, используя кнопки с жестко ограниченными формулировками.
Расскажите про второй подход – создание базы знаний.
Сергей Четвертаков:
База знаний состоит из списка возможных вопросов и ответов, собранного на основе нормативной документации, инструкций и других источников. Преимущество базы знаний для обучения ботов в том, что вся информация, которую будут использовать роботы, структурирована, проверена и приведена к единым стандартам. Это позволяет роботам давать более точные и релевантные ответы пользователям.
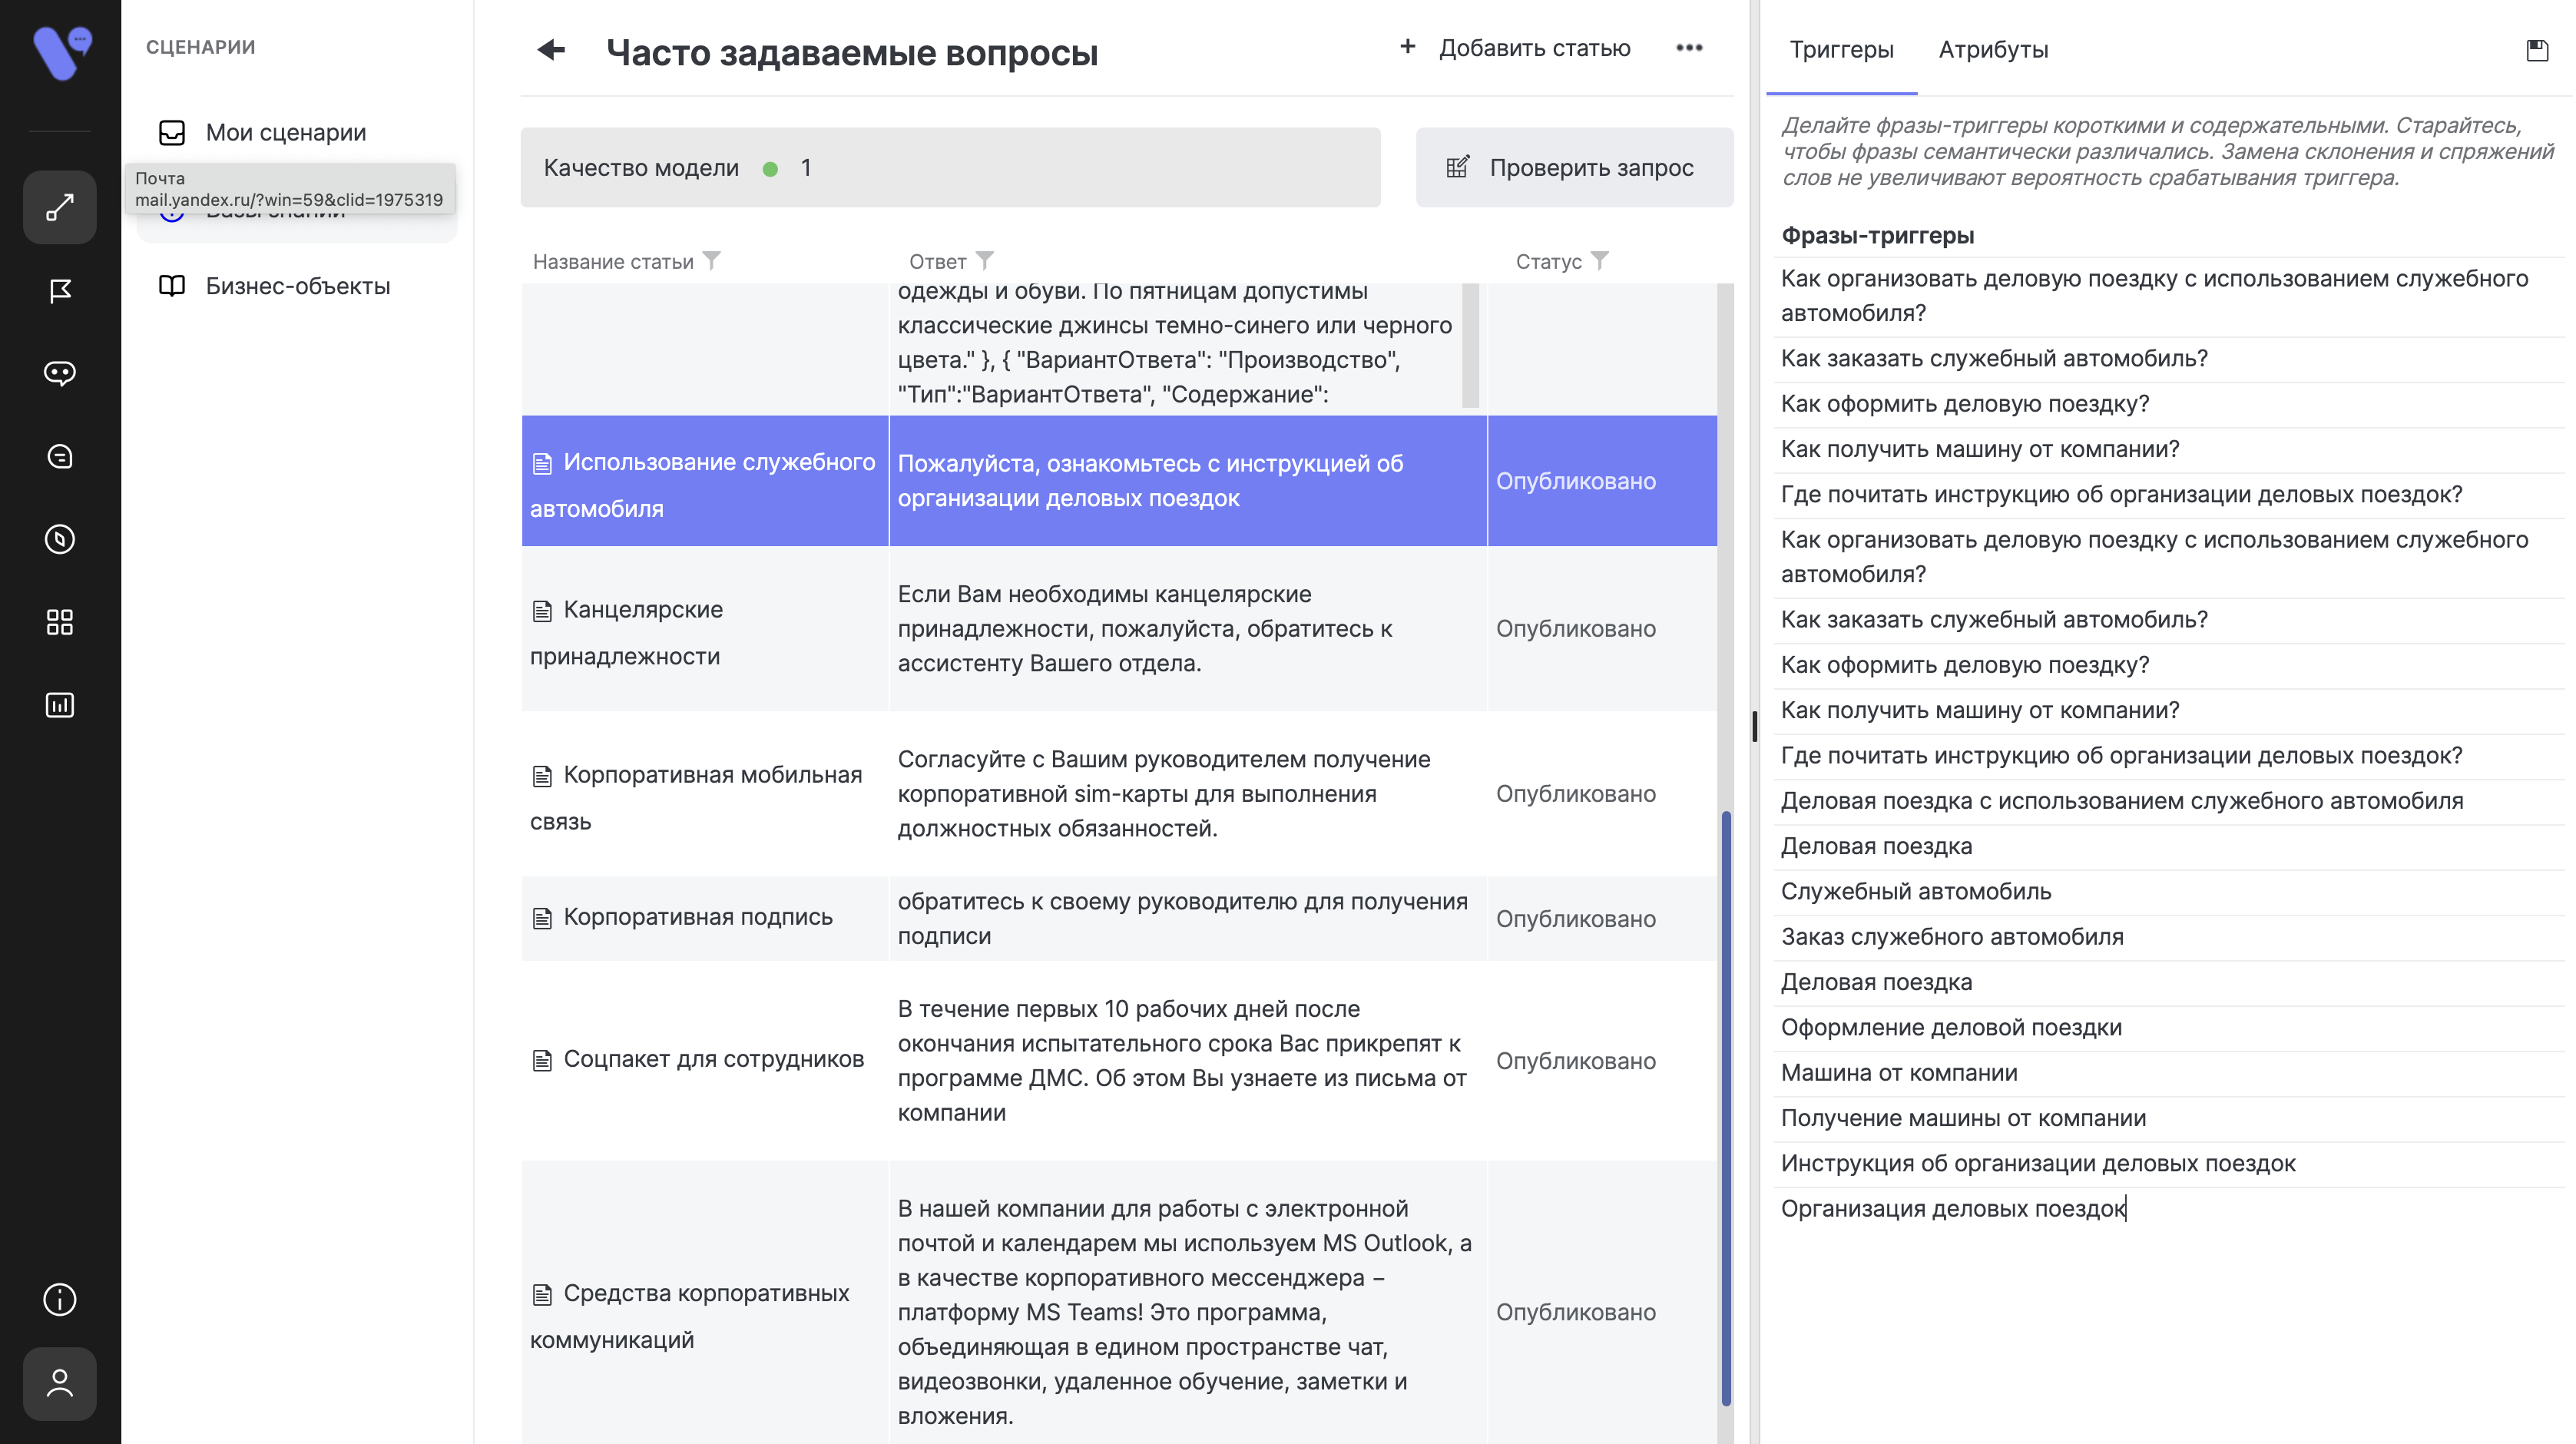
Как правило, у компаний, в которых есть служба поддержки, уже есть такие данные – к ним обращаются операторы, когда консультируют клиентов. Если готовых данных нет – нужно сформировать базу знаний по нужным тематикам, что потребует от компании определенных усилий и временных затрат. Но результат на выходе того стоит. Чем больше специализированной информации содержится в базе знаний, тем лучше бот может отвечать на узкопрофильные вопросы.
После того, как база знаний сформирована, модель обучается правильно классифицировать запросы и находить в ней корректные ответы. Затем модель проходит тестирование: проверяется качество ответов, с помощью кластерного анализа выявляются группы вопросов, на которые модель не нашла ответ, и база знаний пополняется недостающей информацией.
В промышленную эксплуатацию бот запускается с объемом знаний, который будет обеспечивать необходимый уровень точности ответов. После запуска разработчики отслеживают работу бота, проверяют качество ответов, собирают запросы от пользователей, ответы на которые не были изначально заложены и добавляют их в базу знаний.
Таким образом, после запуска бот постоянно обучается в диалогах с пользователями, расширяет область своих знаний и повышает качество ответов. В дальнейшем база знаний расширяется по мере необходимости и пополняется новыми сведениями, изменениями процедур и регламентов.
Если подводить итог, какой подход Вы бы порекомендовали?
Сергей Четвертаков:
Обучение диалогов, хотя и кажется более простым, сталкивается с проблемой разнообразия формулировок ответов, что затрудняет стандартизацию и приводит к низкой точности ответов. Поверив маркетинговым обещаниям, заказчик в результате не получит ответы нужного качества и все равно придет к формированию базы знаний. Подход с созданием базы знаний потребует больше времени и усилий, но грамотно составленная база знаний с самого начала обеспечит более высокую точность и эффективность работы роботов.
Есть ли способы применения LLM для обучения ботов, которые действительно эффективны?
Сергей Четвертаков:
Во-первых, с помощью LLM можно проверять ответы роботов. Ответ пропускается через LLM и, если модель определяет, что ответ нерелевантен, то она дает пользователю свой ответ. Этот ответ всегда более точен, поскольку LLM лучше улавливает нюансы вопроса и отвечает всегда более адресно.
Во-вторых, если у компании нет готовой базы знаний, но есть, например сайт, на котором консолидирован большой объем информации, LLM-модель можно обучить на всем текстовом контенте сайта, включая описания продуктов, FAQ, правила и политики и т.д. Основное преимущество LLM – способность к суммаризации и выделению главного из большого объема информации формулированию компактного ответа. Модель можно обучить на данных компании, и она будет консультировать клиентов на основе специфической информации о компании, ее продуктах и услугах.
В результате, виртуальный помощник с GPT не будет отвечать длинными, сложными статьями из базы знаний. Он проанализирует информацию из нескольких источников на сайте компании, выберет наиболее релевантную и сгенерирует короткий, точный ответ на естественном языке, понятном клиенту. Такой подход значительно повышает качество клиентского опыта – клиентам не нужно изучать сложные, написанные формальным языком статьи в поисках нужной информации. Помощник с GPT быстро даст компактный и понятный ответ
Сценарии применения LLM в клиентской службе понятен. Расскажите о том, как они помогают решать корпоративные задачи.
Сергей Четвертаков:
LLM уже достаточно активно используются компаниями для оптимизации работы с документами. Корпоративные помощники, интегрированные с LLM, ведут интеллектуальный поиск и анализ информации в больших массивах корпоративных данных. Для этого компании не нужно специально готовить данные, достаточно имеющейся в наличии документации.
Сотрудники отправляют помощнику запрос, и он быстро находит нужную информацию и дает ответ в виде краткой выжимки из длинного документа, экономя время на его изучение. Сотрудники могут задавать вопросы на простом, неформальном языке, а LLM извлекает нужную информацию из сложных официальных текстов. Также LLM понимают контекст и намерение запроса, что позволяет находить релевантную информацию даже если точные ключевые слова отсутствуют.